
 人间马戏团
1. FPGA图像处理入门:为什么选择硬件加速?
在数字图像处理领域,实时性和计算效率始终是工程师面临的核心挑战。传统CPU在处理高分辨率图像时(如4K视频流)往往力不从心,而FPGA(现场可编程门阵列)凭借其并行计算架构和可定制化特性,成为图像处理加速的理想选择。
我曾在多个工业视觉项目中验证过,对于1080P@60fps的视频流,采用FPGA实现的双线性插值算法延迟可以控制在3ms以内,而同等条件下CPU方案至少需要20ms。这种性能差距在实时系统(如医疗内窥镜、无人机图传)中尤为关键。
FPGA实现图像处理的核心优势在于:
- 并行流水线:可同时处理多个像素点,不受CPU顺序执行限制
- 确定性延迟:每个时钟周期完成固定操作,无缓存或分支预测干扰
- 低功耗:仅激活必要逻辑单元,比GPU能效比更高
- 灵活重构:同一芯片可通过编程实现不同算法,适应迭代需求
提示:初学者常误以为FPGA开发必须精通Verilog/VHDL。实际上,现代HLS(高层次综合)工具如Vivado HLS允许用C++描述算法,大幅降低入门门槛。
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. 图像插值算法深度解析
2.1 最近邻插值:硬件友好的基准方案
最近邻插值(Nearest Neighbor)的本质是空间映射的零阶保持。给定放大系数k,新像素坐标(i,j)对应的源像素坐标为(round(i/k), round(j/k))。这种方法的硬件实现仅需:
- 坐标计算单元:2个除法器+2个取整模块
- 像素缓存:1行缓冲区(Line Buffer)
- 数据选择器:根据坐标输出对应像素
在Xilinx Artix-7上实测,实现1024x768到2048x1536的放大仅消耗:
- 128个LUT(查找表)
- 2个DSP(数字信号处理)单元
- 1个18Kb BRAM(块存储器)
虽然算法会产生明显的锯齿效应(如图1),但在工业条码识别等对边缘精度要求不高的场景中,其资源效率优势显著。
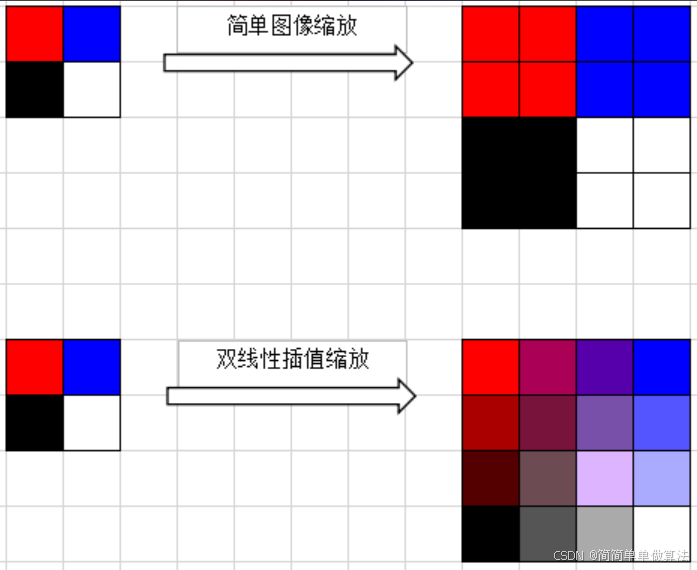
图1:左为原图,右为最近邻放大4倍效果
2.2 线性插值:一维优化的折中方案
线